1. 시간 단축을 위한 공간 규칙
- Data Structure Augmentation
- Store Precomputed Results
- Caching
- Lazy Evaluation
2. 공간 절약을 위한 시간 규칙
- Packing
- Interpreters
3. 루프 규칙
- Code Motion Out of Loops
- Combining Tests
- Loop Unrolling
- Transfer-Driven Loop Unrolling
- Unconditional Branch Removal
- Loop Fusion
4. 논리 규칙
- Exploit Algebraic Identities
- Short-Circuiting Monotone Funtions
- Precompute Logical Funtions
- Boolean Variable Elimination
5. 프로시저 규칙
- Collapsing Function Hierarchies
- Exploit Common Cases
-Coroutine
- Transformations on Recursive Functions
- Recursive -> Iterative
- Stack
- Removing Tail Recursion
- Assistant Procedure
- Parallelism
6. 수식 규칙
- Compile-Time Initialization
- Exploit Algebraic Identities
- Common subexpression Elimination
- Pairing Computation
- Exploit Word Parallelism
※ reference
Programming Pearls 2/e
2019년 8월 10일 토요일

2018년 11월 7일 수요일
rsync : and :: difference
There are two different ways for rsync to contact a remote system.
(:) remote-shell program as the transport (such as ssh or rsh)
(::) rsync daemon directly via TCP. ** => another using method: rsync:// URL
(:) remote-shell program as the transport (such as ssh or rsh)
(::) rsync daemon directly via TCP. ** => another using method: rsync:// URL
2018년 6월 12일 화요일
ACM - 뱀


[2018-06-12]
링크: https://www.acmicpc.net/problem/10875
뱀의 모든 좌표를 한개씩 저장하게되면 약 40PB가 필요하다. 메모리 제한에 걸린다. 좌표를 하나씩 보는 것이 아닌 직선 정보처럼 양끝점을 가지고 있고, 뱀이 이동하면서 그러한 직선들이 계속 갱신되거나 합쳐진다면 뱀의 좌표들을 저장할 공간을 상당히 많이 줄일 수 있을것이다. 어차피 뱀은 수평방향과 수직방향으로만 이동하기 때문에, 방향성을 고려하지 않고 수평방향과 수직방향에 대한 정보를 map으로 저장했다. 최대 L*2(200MB)크기 만큼의 메모리가 필요하기에 주어진 조건에 맞다.
※ 더 최적화 할 수 있는 방법
직선이 아닌 사각형 형태로 저장할 수 있다면, 메모리를 더 줄일 수 있을거 같다. 문제는 사각형을 어떠한 기준으로 나눌 것인가 이다. 추후에 이 방법으로 풀어보려고 한다.
2018년 6월 9일 토요일
GCC 컴파일러와 VC++ 컴파일러의 Associative container (set, map)의 Iterator 처리 차이점
- Content
VC++은 연관 컨테이너인 set과 map에서 iterator 변수가 begin()인 시작 iterator를 가지고 있을때, -- 연산자를 하게되면 end() 로 가게된다.
GCC는 end()가 아닌 바로 그 전의 주소값을 접근한다. (잘못된 메모리 접근)
- Ex
std::set<int> s;
std::map<int, int> m;
bool sb = false;
bool mb = false;
s.insert(2);
s.insert(3);
auto iter1 = s.begin();
iter1--;
sb = iter1 == s.end();
m[1] = 2;
m[2] = 3;
auto iter2 = m.begin();
iter2--;
mb = (iter2 == m.end())

2017년 6월 11일 일요일
ACM - 습격자 초라기


[2017-06-11]
한 위치를 기준으로 0~2만큼 이동하기에 10,000 x 10,000만큼의 배열은 필요없다. 10,000 x 5만큼 필요할 것이다. 위의 방식을 적용하기 위해서는 배열이 아닌 map이 적당하다고 생각했다. map을 이용하면 직관적으로 memoization을 구현할 수 있기에 쉽게 풀 수 있다.
단, 환형이기 때문에 index가 0과 N-1인 부분을 고려해야한다.
※ 더 최적화 할 수 있는 방법
memoization을 사용했음에도 시간제한을 아슬아슬하게 통과했다. map은 balanced tree로 구현되어 있고 search 시간이 log(N)이기 때문에 생각보다 많이 나온 것 같다. 이를 줄이기 위해서는 직관적으로 memoization을 구현하지 않고 두 개의 층을 10,000개의 배열로 사용한다. map의 경우, N이 최대가 10,000이니 밑이 2인 log로 본다면 14번의 탐색이 필요하다. 하지만 배열은 direct access로 1번만에 검색이 가능하다. map이 아닌 배열을 사용하고 dynamic programming에 맞게 규칙을 만들 수 있다면 지금보다 시간을 1/14 (120ms) 정도로 줄일 수 있을 것으로 본다.
[2017-07-12]


unordered_map을 보는 순간 초라기 문제가 다시 생각나서 글을 추가하게 되었다. map은 탐색시간이 log(N)이 걸리기 때문에 unordered_map 즉, hash_table 방식을 이용하여 탐색시간을 O(1)으로 속도를 최적화 할 수 있다. 하지만 hash 값을 만드는 과정에서 오버헤드가 발생하며 hash값이 충돌될 경우에도 그에 따른 탐색 시간이 더 걸린다. hash값을 이용하기때문에 key값으로 pair객체를 사용하던 것을 int로 바꿈으로써 객체가 생성되는 오버헤드도 줄일 수 있었다. hash값을 만드는 함수는 key 값 그대로를 반환하게 구현하여 서로 collision되지 않게 하였다. 그래도 이상적인 시간보다는 4배정도 더 걸린다.
2017년 6월 4일 일요일
ACM - Computer Transformation


링크: https://www.acmicpc.net/problem/3777
이 문제는 풀기전에 1001이 어떻게 나타나는지 n이 5이상일 경우를 직접 종이에 그려보면 규칙이 보입니다. RPG와 같은 방식으로 DFS 재귀적인 방법과 memoization을 사용하였습니다. 이 문제가 까다로웠던 이유는 n이 최대 1000이기에 2^1000은 대략 301자리 숫자이며 unsigned long long(18446744073709551615)의 숫자 범위를 훨씬 뛰어 넘는 범위이기에 직접 큰 수를 표현해야하는 사용자 정의 자료형 BigInteger class를 만들어야 했습니다. 저는 조금이라도 속도를 개선하기 위해서 n이 65일때 까지는 unsigned long long으로 계산하고 66이상부터는 직접 만든 class로 계산한 hybrid transformation을 구현하였습니다.
※ 더 최적화 할 수 있는 방법
n이 커질 때마다 1과 0의 sequence가 규칙적으로 증가하는 것으로 보인다. 이 규칙을 이용하면 재귀적인 호출 방식을 사용하지 않고 구할 수 있지 않을까?
ACM - 36진수


링크: https://www.acmicpc.net/problem/1036
주어진 입력 문자열들을 길이 순으로 정렬하고 각각 숫자들을 하나씩 'Z'로 바꿔보고 합을하여 비교를 했습니다. 그 합에 따라 크기 순으로 정렬하고 바꿔야할 숫자 K개만 가져올 수 있었습니다. 36진수를 계산하기위해 각각 한 자리씩 10진수로 변환하여 계산하였습니다.
ACM - RPG


링크: https://www.acmicpc.net/problem/1315
Dynamic Programming이 핵심입니다.
memoizaiton을 사용하여 힘, 지능 [1001][1001] 배열 3개를 사용하였습니다.
두 가지 memoization cache 배열을 사용하여 누적 포인트에 대한 cache 와 성공횟수에 대한 cache를 만들었습니다. (pnt_cache, success_cache)
남은 한 개의 cache 배열(res_cache)은 재귀를 사용하여 DFS 방식으로 (힘, 지능)을 순회하며 기록하기 위한 배열입니다. 같은 곳을 호출한다면 더 내려가지 않고 바로 반환할 수 있게 하기 위해서 입니다.
※ 더 최적화 할 수 있는 방법
pnt_cache, success_cache 두 배열을 출력해보면 누적 포인트 변화와 성공 횟수에 따른 변화점이 같다. 이 성질을 이용하면 res_cache와 DFS 재귀 방식을 사용하지 않고 답을 구할 수 있을 것 같다. loop를 1000*1000*100번 만으로 끝낼 수도 있을 것이다.
2017년 5월 15일 월요일


2017년 4월 5일 수요일
알고리즘 문제 해결 전략 - 7장 분할 정복(Divide & Conquer)
분할 정복(Divide & Conquer)
주어진 문제를 둘 이상의 부분 문제로 나눈 뒤 각 문제에 대한 답을 재귀 호출을 이용해 계산하고, 각 부분 문제의 답으로부터 전체 문제의 답을 계산
※ 분할 정복이 일반적인 재귀 호출과 다른 점은 문제를 한 조각과 나머지 전체로 나누는 대신 거의 같은 크기의 부분 문제로 나누는 것입니다.
※ 분할 정복은 많은 경우 같은 작업을 더 빠르게 처리해 줍니다.
1. 분할 정복을 사용하는 알고리즘 세 가지의 구성 요소
- 문제를 더 작은 문제로 분할하는 과정(divide)
- 각 문제에 대해 구한 답을 원래 문제에 대한 답으로 병합하는 과정(merge)
- 더이상 답을 분할하지 않고 곧장 풀 수 있는 매우 작은 문제(base case)
if) n==1000


reference) 프로그래밍 대회에서 배우는 알고리즘 문제 해결 전략
2017년 3월 26일 일요일
COINS
Problem : COINS
Address : https://algospot.com/judge/problem/read/COINS
Language : C++
Address : https://algospot.com/judge/problem/read/COINS
Language : C++
Time : 30minute


2017년 2월 19일 일요일
BOGGLE
Problem : BOGGLE
Address : https://algospot.com/judge/problem/read/BOGGLE
Language : C++
Address : https://algospot.com/judge/problem/read/BOGGLE
Language : C++
Time : 20minute


2017년 2월 7일 화요일
NQUEEN
Problem : NQUEEN
Address : https://algospot.com/judge/problem/read/NQUEEN
Language : C++
Address : https://algospot.com/judge/problem/read/NQUEEN
Language : C++
Time : 30minute


2017년 2월 5일 일요일
알고리즘 문제 해결 전략 - 6장 무식하게 풀기(brute-force)
무식하게 풀기(brute-force)
- 완전 탐색(exhaustive search) : 가능한 방법을 전부 만들어 보는 알고리즘1. 반복문
- 입력 개수가 적다면 간결하고 단순하지만 골라야 하는 원소의 수가 늘어날수록 코드가 길고 복잡해지는데다, 골아야 할 원소의 수가 입력에 따라 달라질 수 있는 경우에는 사용할 수 없다.
2. 재귀 함수(recursive function) 혹은 재귀 호출(recursion)
- 재귀 호출은 위와 같은 문제의 경우에 단순한 반복문보다 간결하고 유연한 코드를 작성할 수 있도록 해줍니다.
※ 기저 사례(base case)
모든 재귀 함수는 '더이상 쪼개지지 않는' 최소한의 작업에 도달했을 때 답을 곧장 반환하는 조건문을 포함해야 합니다. 쪼개지지 않는 가장 작은 작업들을 가리켜 기저 사례(base case)라고 합니다.
ex1) n개의 원소 중 m개를 고르는 모든 조합을 찾는 알고리즘
if) n==7, m==4
ex1-1) 반복문 이용

ex1-2) 재귀 함수 이용

ex2) 보글 게임: 주어진 칸에서 시작해서 특정 단어를 찾을 수 있는지 확인하는 문제

reference) 프로그래밍 대회에서 배우는 알고리즘 문제 해결 전략
2017년 1월 16일 월요일
알고리즘 문제 해결 전략 - 3장
- 정렬되지 않은 정수 배열에 중복 원소가 존재하는지 확인하는 함수

- [자주하는 실수] - < 연산자의 성질 (strict weak ordering)
1. a<a는 항상 거짓입니다. - 비반사성(irreflexivity)
2. a<b가 참이면 b<a는 거짓입니다. - 비대칭성(asymmetry)
3. a<b가 참이고 b<c가 참이면 a<c입니다. - 전이성(transitivity)
4. a<b와 b<a가 모두 거짓이면 a와 b는 같은 값으로 간주합니다. - 상등 관계의 전이성(transitivity of equivalence)
=> a와 b가 같고, b와 c가 같다면 a와 c도 같아야 합니다.
ex)
- 두 정수 집합의 포함 관계를 파악하는 잘못된 비교 함수

{1}, {2}, {2,3}
{1} < {2,3} false
{2} < {2,3} true
{1} < {2} false
{2} < {1} false
4번 성질에 의해 {1} = {2}
{1} < {2, 3} false
{2, 3} < {1} false
4번 성질에 의해 {1} = {2,3}
{1} = {2} = {2,3} ?
- 두 정수 집합의 포함 관계를 파악하는 비교 함수

a와 b가 완전히 같은 경우를 제외하고는 어느 때도 두 집합이 같다고 판단하지 않는 것입니다. 우리가 원하는 조건이 성립하지 않는 두 집합에 대해서도 별도의 순서를 정해 줘야 합니다.
※ 사실 진부분집합 확인은 의미가 없다.
- [디버깅과 테스팅] - 스캐폴딩(scaffolding)
프로그램을 테스트할 때 유용하게 사용할 수 있는 기법
알고리즘 문제 해결에서 스캐폴딩은 코드의 정당성을 확인하거나 반례를 찾는데 유용하게 쓰입니다.
reference) 프로그래밍 대회에서 배우는 알고리즘 문제 해결 전략
2016년 12월 15일 목요일
Pointer Operation
Valid pointer operations are assignment of pointers of the same type.
2. subtracting or comparing two pointers to members of the same array
3. assigning or comparing to zero
All other pointer arithmetic is illegal except for 1~3.
2. to multiply or divide or shift or mask
3. to add float or double
4. to assign a pointer of one type to a pointer of another type without a cast
※ except for void *


- Possible Pointer Operation
2. subtracting or comparing two pointers to members of the same array
3. assigning or comparing to zero
All other pointer arithmetic is illegal except for 1~3.
- Impossible Pointer Operation
2. to multiply or divide or shift or mask
3. to add float or double
4. to assign a pointer of one type to a pointer of another type without a cast
※ except for void *
- Pointer Operation Result Example
x86 system is 4byte pointer
x64 system is 8byte pointer
The example is x86 system. (but acutal system is x64 system)
integer 1 = 0x4

p2 = p1 + 4;
integer 4 is address 16(0xf) by pointer operation
p3 = p2 - p1
p3 is 4 by pointer operation but not 16(0xf)
2016년 11월 20일 일요일
Flexibly convert string input to integer array


- EOF(End Of File input method)
Unix/Linux : ^D (Ctrl +D)
reference) K&R2 Book
Performance Comparison Source
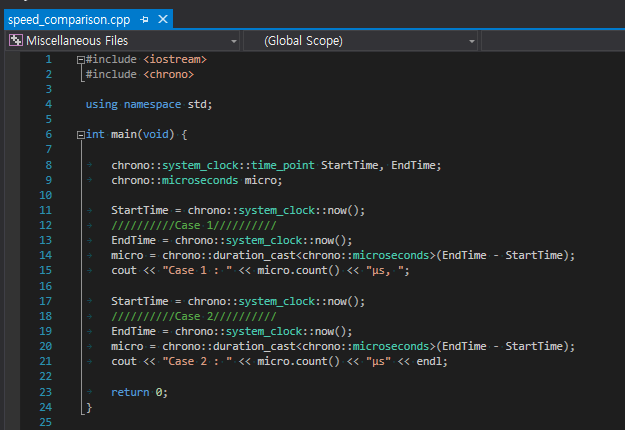
chrono is a time libray added to C++11. It offers more functions than the existing ctime. Also, It can measure up to nano units.
Ex) Branch(if) VS % operation
When you use an array as a circular array, you must choose branch or % operation.
(This Example should overwrite the array if it is full.)


피드 구독하기:
글 (Atom)